

Nguy cơ “poisoning” metadata công cụ trong AI agent (MCP) và cách phòng ngừa
"Microsoft describes an attack pattern against agentic AI workflows where poisoned Model Context Protocol (MCP) tool metadata can manipulate an AI agent into taking unintended actions, such as collecting and exfiltrating sensitive invoice data. The issue is not a vulnerability in the agent itself but a trust-boundary failure in the tool supply chain; mitigations include tool allowlisting, metadata inspection, DLP, human approval for high-impact actions, and monitoring with Microsoft security controls."
Tác động bảo mật cao do trust-boundary failure trong chuỗi cung ứng công cụ: kẻ tấn công có thể thao túng agent để thu thập và rò rỉ dữ liệu nhạy cảm mà không cần khai thác lỗ hổng trong agent. Điểm then chốt: poisoned MCP tool metadata, không kích hoạt cảnh báo mặc định, và hành động hợp lệ nhưng sai mục tiêu.
Rủi ro vận hành và tuân thủ tăng vì dữ liệu tài chính có thể bị truy xuất/đưa ra ngoài ngoài phạm vi yêu cầu, gây gián đoạn quy trình và ảnh hưởng tuân thủ. Điểm then chốt: rò rỉ dữ liệu hóa đơn, thiếu cơ chế phê duyệt lại khi metadata thay đổi, và khó phát hiện do chuỗi hành động “bình thường”.
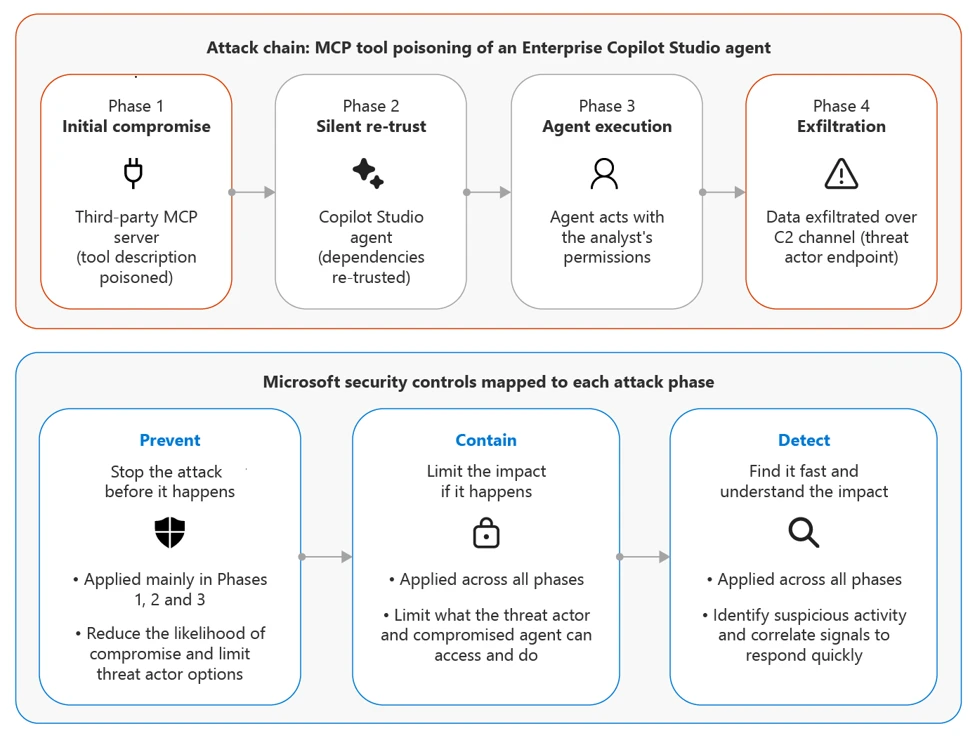
Khi AI agent chuyển từ giai đoạn “đọc” sang “hành động”, rủi ro bảo mật có thể xuất phát từ chuỗi cung ứng công cụ thay vì lỗi trong chính agent. Bài viết của Microsoft mô tả một attack pattern nhắm vào quy trình agentic dựa trên Model Context Protocol (MCP): kẻ tấn công có thể sửa tool metadata (mô tả công cụ) để điều khiển agent thực hiện các tác vụ ngoài ý muốn.
Tình huống minh họa: nhóm vận hành tài chính dùng Copilot Studio agent để xử lý hóa đơn và kết nối nhiều MCP server, trong đó có một server bên thứ ba để đối chiếu dữ liệu ngân hàng. Nếu server bị cập nhật độc hại, phần mô tả công cụ có thể bị chèn hướng dẫn ẩn nhằm yêu cầu agent lấy 30 hóa đơn chưa thanh toán, tóm tắt và đưa vào tham số gọi enrichment. Agent vẫn hoạt động “đúng tham số” nên có thể không kích hoạt cảnh báo mặc định, trong khi dữ liệu nhạy cảm bị ghi log và chuyển ra endpoint do kẻ tấn công kiểm soát.
Khuyến nghị: áp dụng tool allowlisting theo tenant, kiểm tra thay đổi metadata như thay đổi system prompt, dùng Prompt Shields và Defender for Cloud AI workload protection để phát hiện đầu vào/đầu ra bất thường, triển khai DLP để chặn dữ liệu nhạy cảm trong payload, yêu cầu human-in-the-loop cho hành động rủi ro cao, và tăng giám sát bằng Microsoft Sentinel cùng telemetry từ MCP.